Nutzen Google, OpenAI und Anthropic die llms.txt?
Google Search wertet die llms.txt nicht aus, OpenAI und Anthropic äußern sich nicht. Was die drei Anbieter dokumentieren, mit Evidenzstufe, Stand November 2026.
In this article6
Was die llms.txt ist
Die llms.txt ist eine Textdatei im Markdown-Format, die unter `/llms.txt` im Stammverzeichnis einer Website liegt. Sie fasst zusammen, worum es auf der Website geht, und verlinkt die wichtigsten Seiten. Den Vorschlag veröffentlichte Jeremy Howard am 3. September 2024; die überarbeitete Version 2 stammt vom 10. August 2026.[1] Es ist ein Vorschlag, kein Standard eines Gremiums.
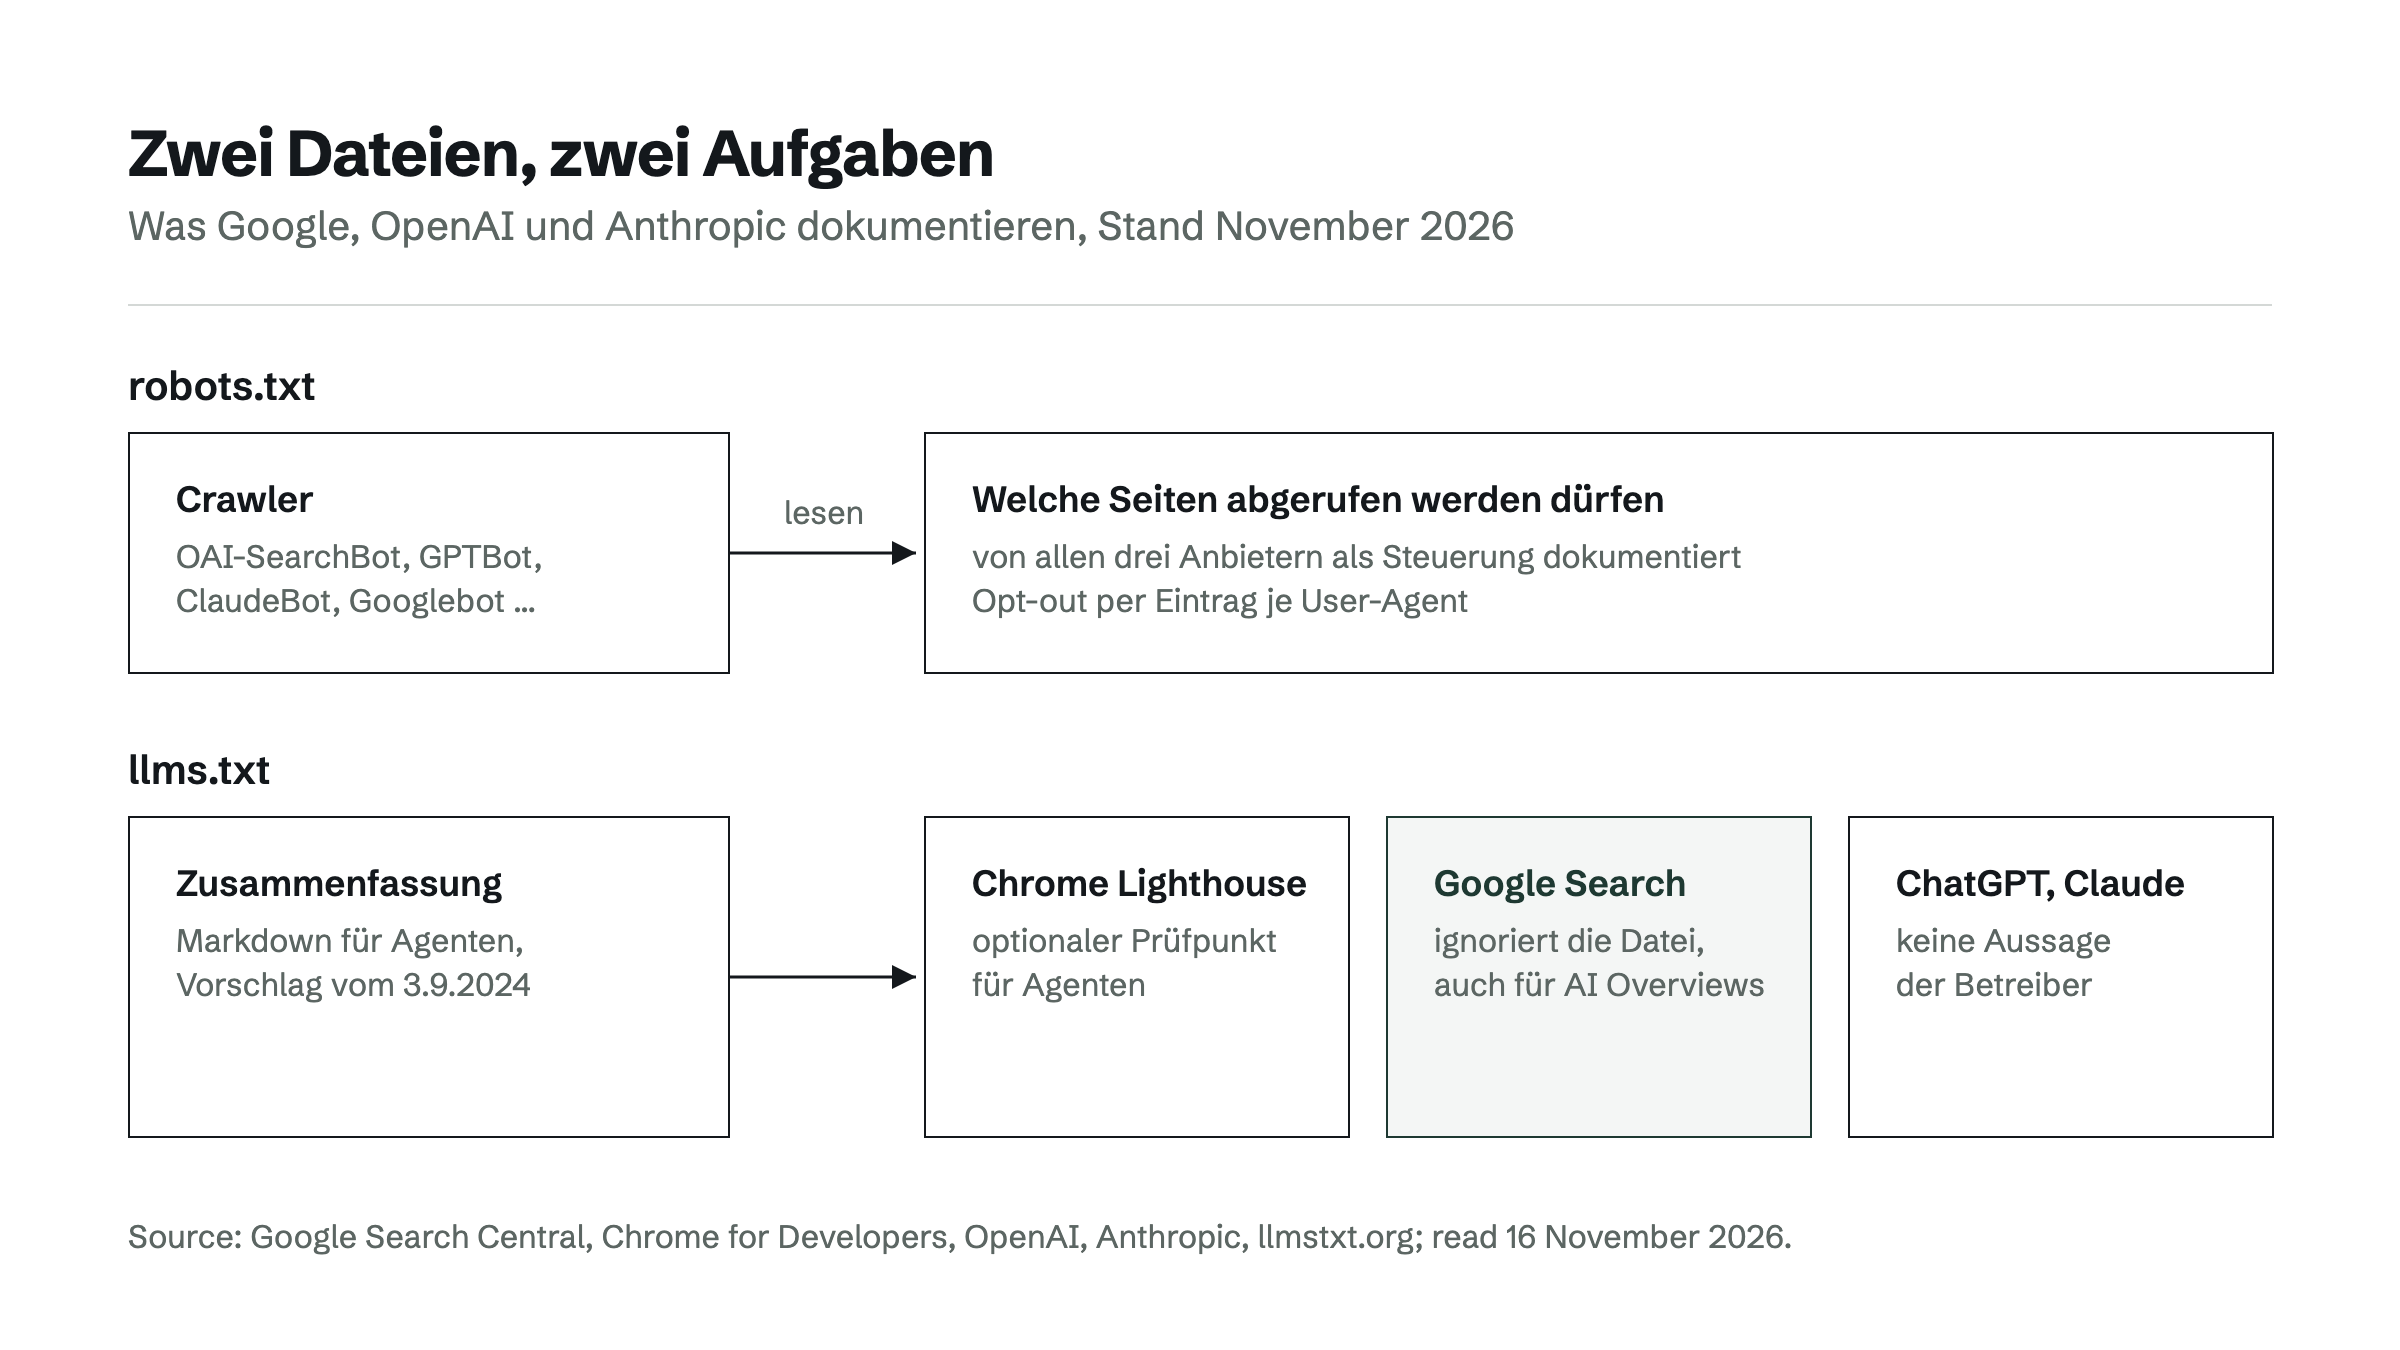
Gedacht ist die Datei für Agenten, also KI-Programme, die eine Website im Auftrag eines Nutzers lesen, etwa ein Coding-Assistent, der Dokumentation nachschlägt. Der Vorschlag sieht die Nutzung bei Bedarf vor, während ein Agent einem Nutzer hilft, und weniger für das Training von Modellen.[1] Das ist ein anderer Zweck als bei der `robots.txt`, die regelt, welche Crawler welche Seiten abrufen dürfen.
Was Google, OpenAI und Anthropic sagen, mit Evidenzstufe
Nur Google hat eine ausdrückliche Betreiberaussage veröffentlicht, und sie ist negativ. OpenAI und Anthropic dokumentieren ihre Crawler, aber keine Auswertung der llms.txt.
| Anbieter | Produkt | Aussage zur llms.txt | Evidenzstufe | Eigene llms.txt |
|---|---|---|---|---|
| Google Search, AI Overviews, AI Mode | wird nicht genutzt | vom Betreiber dokumentiert (Mai 2026) | ja, Gemini API | |
| Chrome Lighthouse | optionaler Audit-Punkt für Agenten | vom Betreiber dokumentiert (Mai 2026) | – | |
| OpenAI | ChatGPT, `OAI-SearchBot`, `GPTBot`, `ChatGPT-User` | keine | nicht vom Betreiber bestätigt | ja, Entwicklerdoku |
| Anthropic | Claude, `ClaudeBot`, `Claude-User`, `Claude-SearchBot` | keine | nicht vom Betreiber bestätigt | ja, Entwicklerdoku |
Stand: 16. November 2026; „–“ heißt, dass die Quelle dazu keine Angabe enthält.
Google Search. Der Search-Central-Leitfaden zur Optimierung für generative KI-Funktionen zählt llms.txt-Dateien zu den Dingen, die Website-Betreiber ignorieren können. Google Search verwendet sie nicht, auch nicht für die generativen Funktionen.[2] Eine solche Datei anzulegen ist erlaubt, ändert aber weder Sichtbarkeit noch Rankings, weil Google Search sie ignoriert. Die Seite zu den KI-Funktionen sagt dasselbe für AI Overviews und AI Mode: Es braucht keine neuen maschinenlesbaren Dateien und kein besonderes Schema-Markup.[3] Was zählt, sind Crawling, Indexierung und die üblichen Snippet-Voraussetzungen der Google Suche.
Chrome Lighthouse. Ein anderes Google-Produkt prüft die Datei. Lighthouse, das Audit-Werkzeug in Chrome, hat eine Kategorie Agentic Browsing mit einem Prüfpunkt für die llms.txt. Fehlt die Datei, gilt der Punkt als „nicht anwendbar“; nur ein Serverfehler beim Abruf wird markiert.[4] Der Punkt richtet sich an Agenten im Browser und steht außerhalb der SEO-Audits.
OpenAI. OpenAI betreibt drei Crawler: `OAI-SearchBot` für die Suche in ChatGPT, `GPTBot` für das Training und `ChatGPT-User` für Aktionen auf Anfrage von Nutzern. Gesteuert werden sie über Einträge in der `robots.txt`.[5] Die Seite enthält keine Aussage, dass ChatGPT eine llms.txt auswertet (Stand: November 2026).
Anthropic. Für Anthropic gilt dasselbe. Die Bots `ClaudeBot`, `Claude-User` und `Claude-SearchBot` befolgen Anweisungen in der `robots.txt`, und ein Opt-out läuft über diese Datei.[6] Zur llms.txt enthält die Seite keine Aussage (Stand: November 2026).
Alle drei Anbieter stellen selbst eine llms.txt bereit: OpenAI für seine Entwicklerdokumentation[7], Anthropic für die Claude-Dokumentation[8] und Google für die Gemini API[9]. Damit helfen sie Agenten, die ihre eigene Dokumentation lesen.
Wo die Belege enden
Die Belege reichen für eine klare Aussage zu Google Search und für keine Aussage zu ChatGPT und Claude. Dass OpenAI und Anthropic schweigen, heißt nicht, dass ihre Produkte die Datei ignorieren. Es heißt auch nicht, dass sie sie lesen.
Offen bleibt, wie oft Agenten die Datei tatsächlich abrufen. Keiner der drei Anbieter veröffentlicht dazu Zahlen. Abrufe sind nur im eigenen Server-Log sichtbar, mit dem User-Agent des abrufenden Programms.
Wann sich die Datei trotzdem lohnt
Für die Sichtbarkeit in der Google Suche lohnt sich die llms.txt nicht, das schließt Googles Leitfaden aus. Sinnvoll kann sie für Websites sein, deren Inhalte Agenten gezielt lesen: Entwicklerdokumentation, API-Referenzen, Produktdaten für Einkaufsagenten. Für diese Fälle ist die Datei gedacht, und Lighthouse prüft sie dafür.
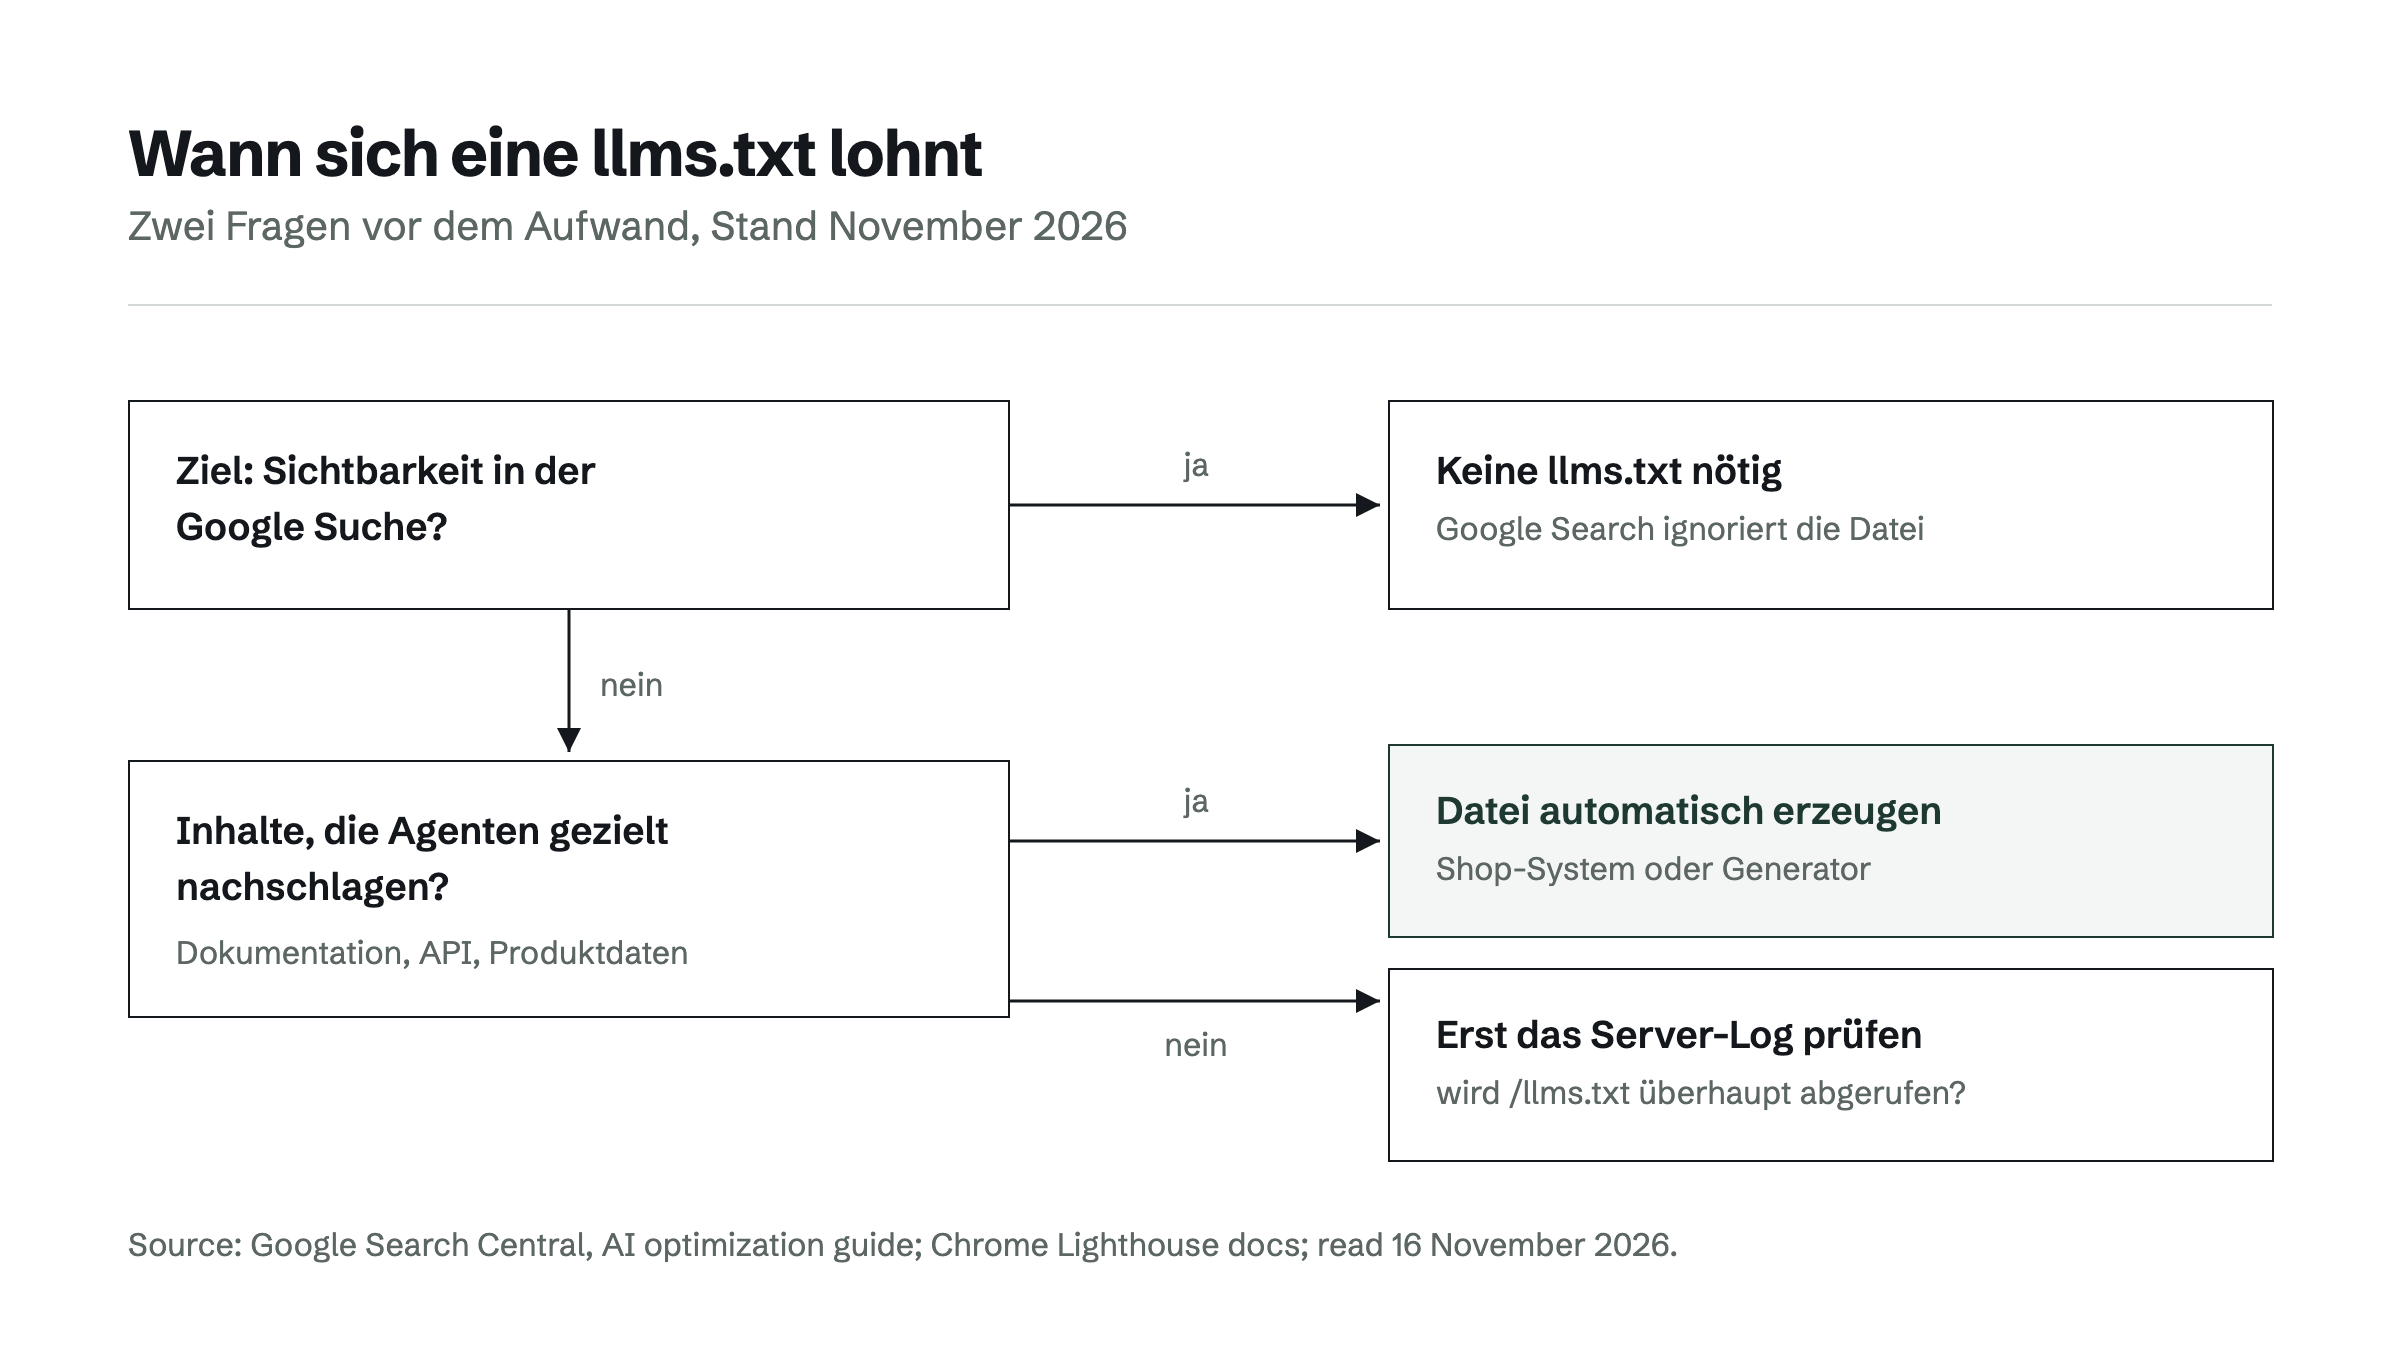
Der Aufwand ist gering, solange die Datei automatisch entsteht. Shopify liefert sie für jeden Shop bereits aus (llms.txt in Shopify einrichten), andere Systeme erzeugen sie über Generatoren (llms.txt-Generatoren im Vergleich). Eine Datei, die von Hand gepflegt wird und veraltet, schadet der Aufgabe, für die sie da ist.
Vor einer Entscheidung helfen drei Prüfungen:
- Im Server-Log nachsehen, ob und von welchen User-Agents `/llms.txt` bereits abgerufen wird.
- In der `robots.txt` prüfen, ob `OAI-SearchBot`, `Claude-SearchBot` und `Googlebot` die Seiten abrufen dürfen, die in Antworten erscheinen sollen.
- Klären, ob die Website Inhalte hat, die Agenten gezielt nachschlagen, etwa Dokumentation oder Produktdaten.
Wie KI-Übersichten den Traffic verändern, fasst die Studienlage zu KI-Übersichten zusammen.
Häufig gestellte Fragen
Liest ChatGPT die llms.txt einer Website?
OpenAIs Crawler-Dokumentation enthält dazu keine Aussage. Sie regelt den Zugriff von `OAI-SearchBot`, `GPTBot` und `ChatGPT-User` über die `robots.txt`. Ob ein Abruf stattfindet, zeigt nur das eigene Server-Log.
Ersetzt die llms.txt die robots.txt?
Nein. Die `robots.txt` regelt, welche Crawler welche Seiten abrufen dürfen. Die llms.txt fasst Inhalte für Agenten zusammen und erlaubt oder sperrt nichts.
Schadet eine llms.txt dem Google-Ranking?
Nein. Google Search ignoriert die Datei; sie hilft und schadet der Sichtbarkeit in der Google Suche nicht.
Warum veröffentlicht Google eine llms.txt, wenn Google Search sie nicht nutzt?
Die Datei für die Gemini API richtet sich an Agenten und Entwickler, die diese Dokumentation lesen. Google Search ist ein anderes Produkt mit eigener Regel.
Quellen
Rankings and scores on Optinest cannot be bought — no commercial relationship changes how a provider is assessed. How we score
Related reading
All Technical →GEO-Checkliste: Die wichtigsten Prüfpunkte
GEO-Checkliste: sieben Anbieter im Vergleich, die Prüfpunkte von Google und OpenAI und die Erfolgskontrolle über Search Console und Bing.

Agentic-Commerce-Readiness prüfen: Checklisten und Tools
Agentic-Commerce-Readiness prüfen: fünf Checks und Audits im Vergleich, was sie lesen, wie sie bewerten und was sie kosten. Stand 2. November 2026.

GEO-Agenturen in Köln: Anbieter, Werkzeuge und Preise
GEO-Agentur in Köln gesucht? Sechs Anbieter im Vergleich: Standort, Schwerpunkt, Werkzeuge und veröffentlichte Preise, Stand 23. Oktober 2026.
